[Reactive Programing] Reactive와 Spring Webflux - 1
오랜만에 블로그에 글을 쓴다.
그동안 정신없이 이것저것 시도하면서 혼자 공부를 하던 중, 이것만은 글로 기록해 둬야겠다는 생각이 들어서다.
나는 보통 어떤 기술에 대해 궁금한게 생기면, 그 기술을 직접 사용하여 무언가를 구현해보며 익히는 편이다.(일단 부딪히고 보는 타입)
이번에도 Kotlin과 Spring Webflux에 관심이 생겨 직접 부딪혀 보며 개발을 하려는데..
너무 욕심이 과했던 탓일까? 이해하기 힘든 부분들이 많아 이대로는 진행이 안되겠다 싶어, 예외적으로 선 공부후 개발에 착수하기로 마음먹었다.
이 글은 그 기록의 시작점이다.
Reactive?
전통적인(그리고 현재 대부분의) Spring 애플리케이션은 차단식 동기 프로그래밍으로 구현되어 있으며, 그 근본에는 절차지향(명령형) 프로그래밍이 있다.
말그대로 코드 한줄한줄 따라 내려가면서 명령어가 수행되는 구조인것이다.
이러한 절차지향 프로그래밍 기법은 일반적으로 “차단(Blocking)”을 유발하며, 이 차단은 리소스의 낭비를 유발한다.
웹 어플리케이션의 Requests(threads)와 Response를 공장 노동자와 생산되는 물건에 비유해보겠다.
노동자와 결과물
어떤 공장에서는 전화를 통해 물건의 생산 주문을 실시간으로 받고, 주문을 받는 즉시 공장 노동자는 생산 작업에 착수하며,
생산 작업이 완료되면 물건을 주문자에게 보낸다. 여러개의 물건 생산 주문을 받으면 여러명의 노동자가 동시에 생산 작업에 착수한다.
그림으로 보면 다음과 같다.
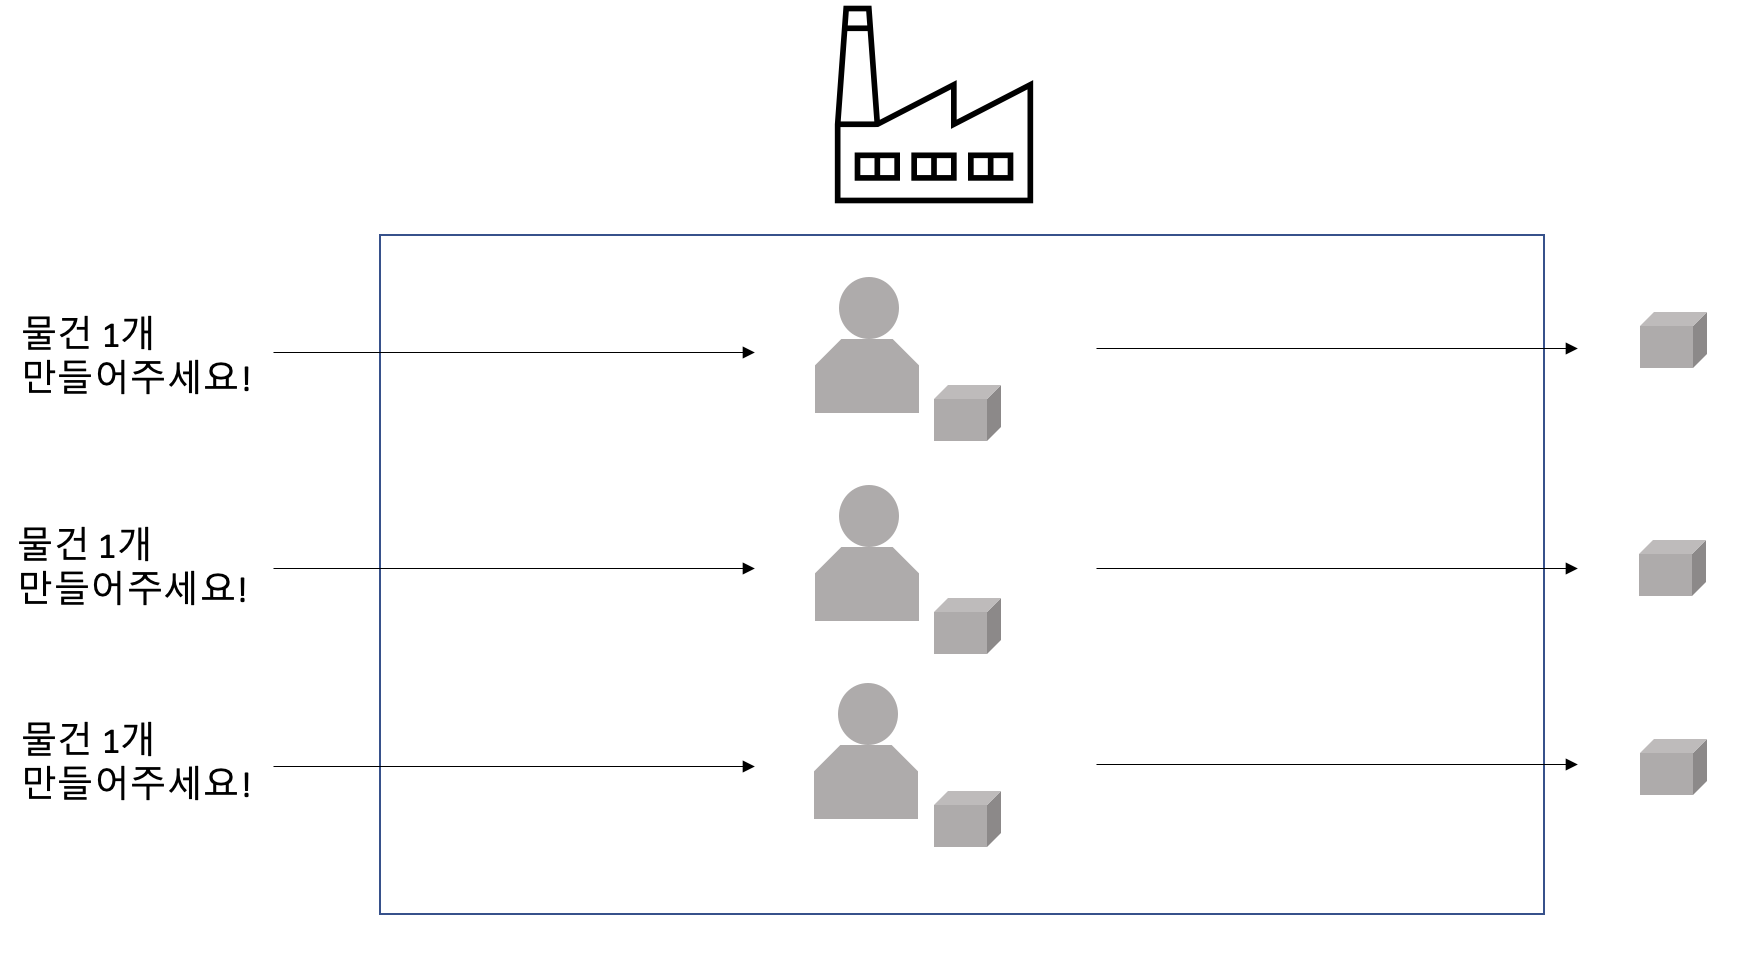
이를 Spring Web Application에 비유하면, 노동자는 Thread로 볼 수 있고, 도토리는 Response로 볼 수 있다. 아래의 그림과 같이 말이다.
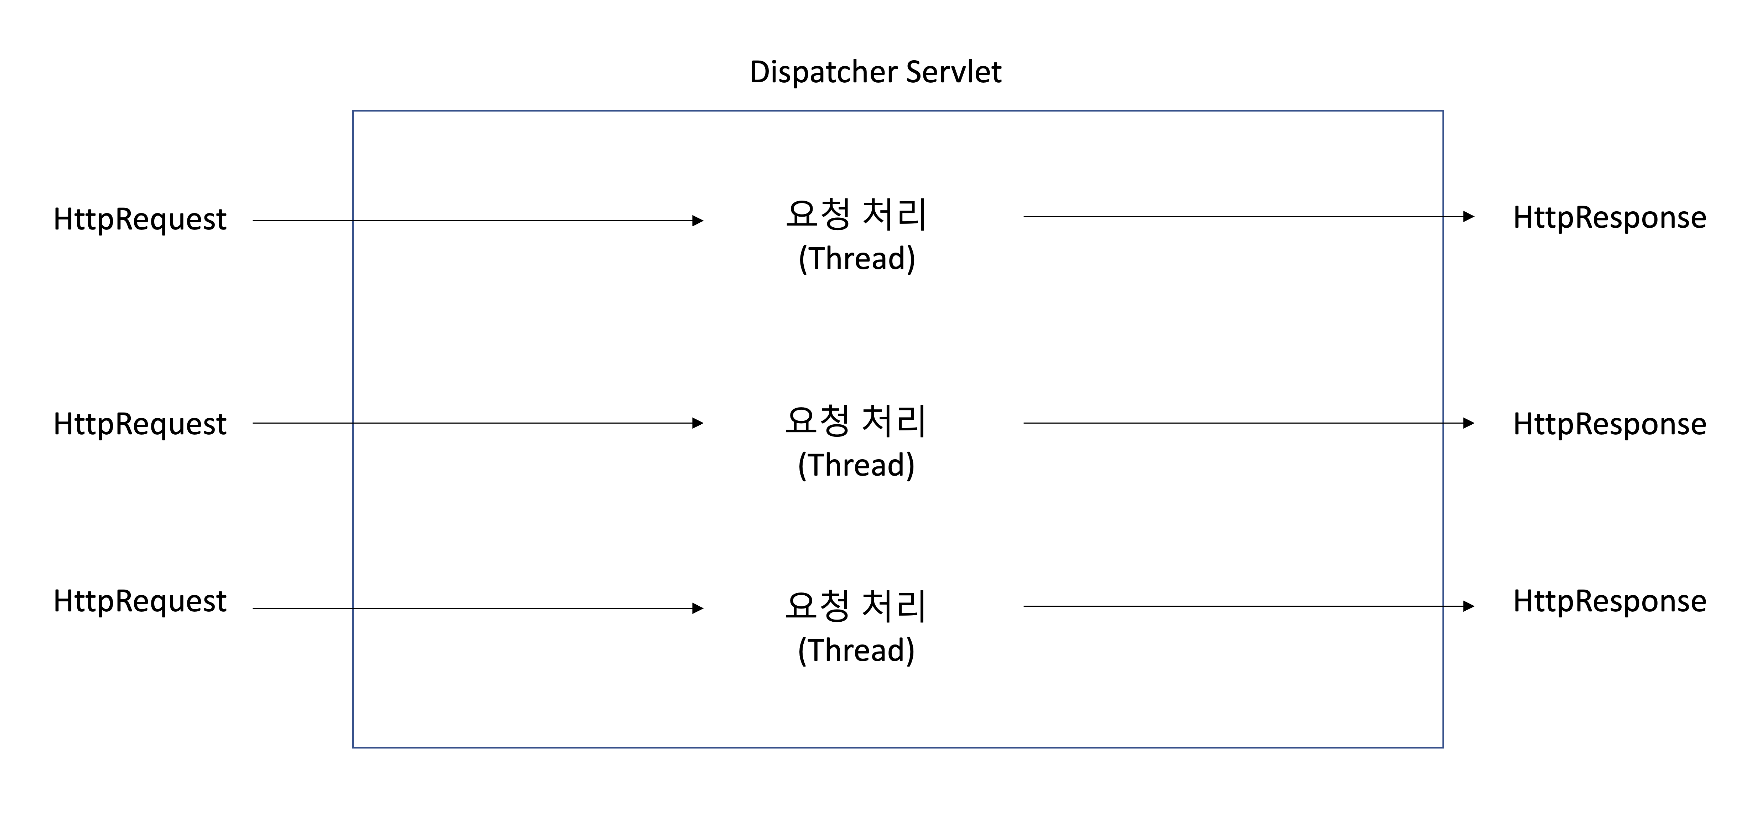
http Request가 오게되면, 서블릿 컨테이너(Tomcat 등)는 Thread Excutor를 통해 각 요청을 Thread로 처리한다. 이 때, 요청마다 별도로 정보를 저장하는 공간은 ThreadLocal이라는 객체를 통해 처리한다.
만약 노동자가 물건 생산 중 물건생산에 필요한 부품이 부족하여, 외부에서 부품을 사와야 하는 상황이 생긴다면? 당연히 노동자는 부품을 구할때까지 만들던 물건을 완성할 수 없고, 아무일도 하지 못할것이다.
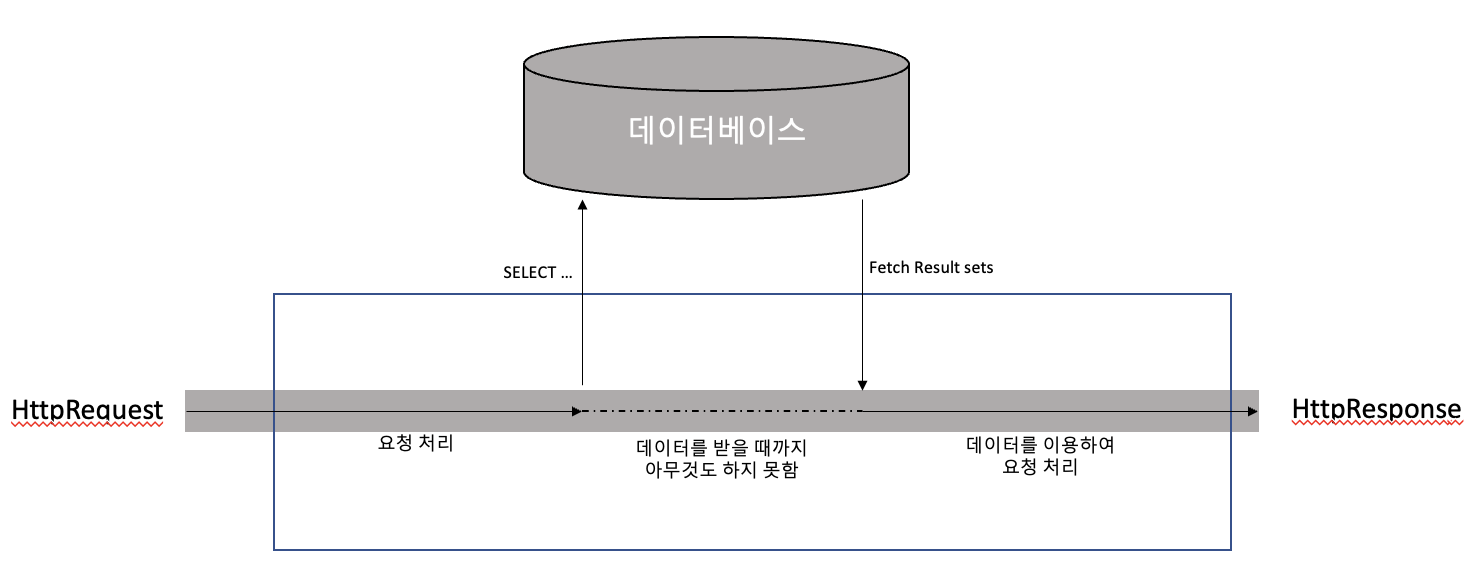
보통의 웹 어플리케이션의 경우 JDBC를 이용하여 데이터베이스에서 정보를 얻어와 요청에 대한 처리를 진행하는 경우가 많다. 이 때 JDBC를 통해 DB에 데이터를 요청하게 되면 Thread는 DB가 데이터를 돌려주기 전까지 아무일도 하지 못하고 기다려야 하는데, 이를 Blocking 상태에 있다고 부른다.
Reactive Programing
이처럼 Thread가 Blocking 상태에 빠져 아무것도 하지못하면, 컴퓨팅 자원이 낭비되는 셈이다.(노동자가 쉬는것처럼)
이를 방지할수 있는 방법중 하나가 바로 Reactive Programing이며, 반응형 프로그래밍이라고도 불리는데, Spring에서는 Spring Webflux가 이 Reactive Programing의 개념을 이용하여 개발되었다. (Non-blocking과 Reactive-streams, Project Reactor에 대해서도 더 다루면 좋겠지만.. 여기서 다 다루기엔 양이 너무 많아서 PASS)
위에서 봤던 공장의 상황을 Reactive Programing 방식으로 다시 바꿔보면 아래와 같다.
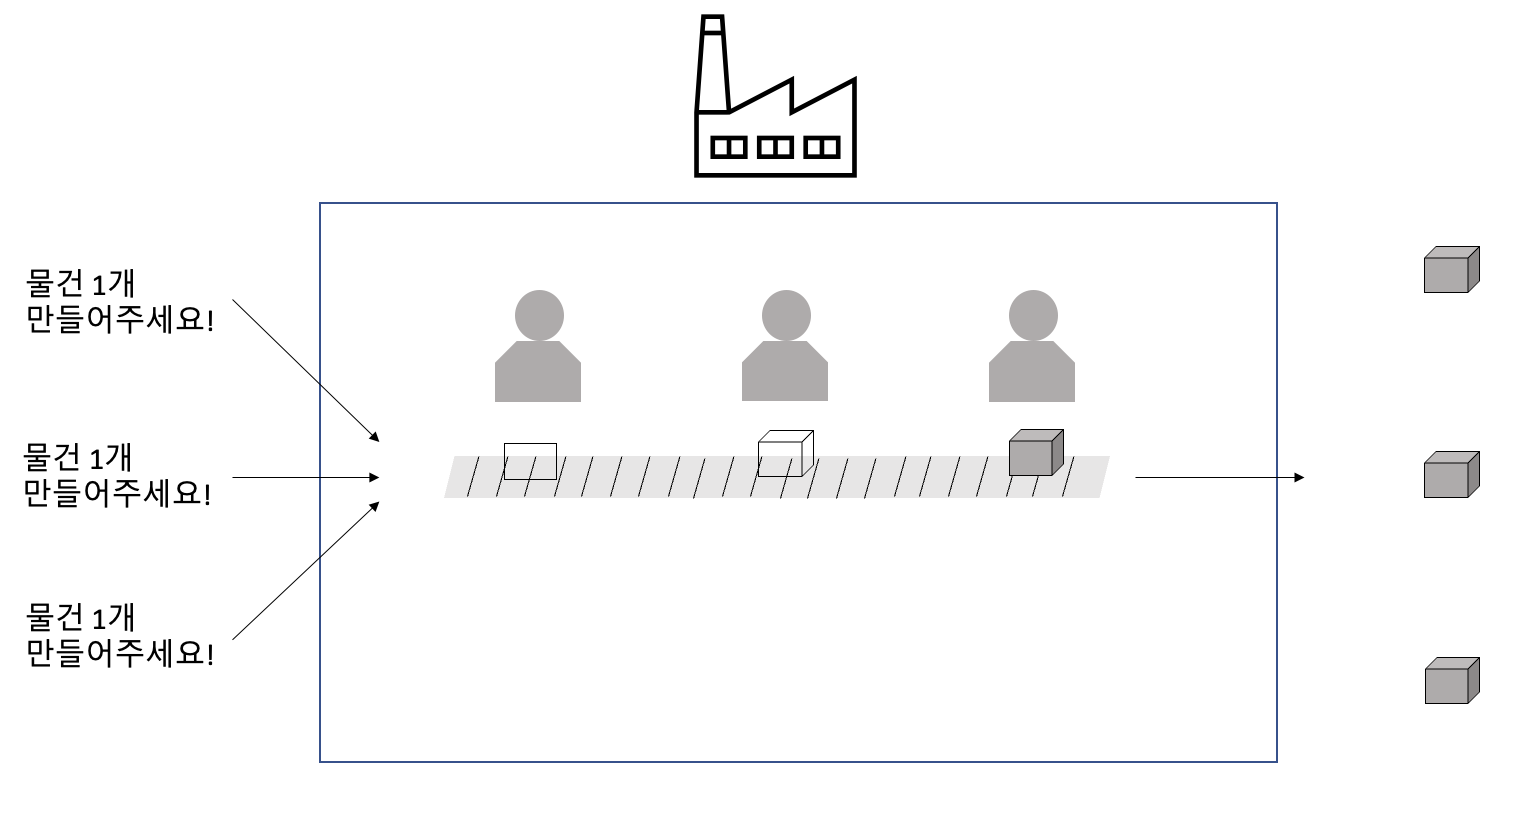
주문이 들어오면, 각자 다른 역할을 맡은 노동자들이 컨베이어 벨트 위에 서고, 물건은 컨베이어 벨트 위를 지나면서 점점 완성되어 가는것이다.
이렇게 되면 노동자들은 쉬지 않고 자신의 일을 하는데에만 집중할 수 있으며, 여기서는 컨베이어 벨트가 Thread로, 노동자는 Thread가 아닌 Operator로 치환하여 생각할 수 있다. 여기서 Operator는 Spring Webflux에서 제공하는 메소드(함수)들로, 데이터를 가공하기 위해 쓰이는 함수들이다.(ex. flatMap, map 등)
장점
이렇게 Spring Webflux를 이용하여 Reactive하게 시스템을 구성해 놓게 되면, 설령 DB와 같은 외부 IO접근을 통하더라도 Thread(컨베이어벨트)는 멈추지 않고 제 할일을 할 수 있다.(물론 JDBC는 blocking 방식의 Connector이기 때문에, 대신 R2DBC라는 Connector를 사용해야한다.)
결과적으로 상황에 따라서 기존 시스템보다 작은양의 컴퓨팅 자원으로도 비슷하거나 그 이상의 성능을 낼 수 있으며, 이는 거시적으로 볼 때 에너지 절약과도 이어진다. 이러한 점으로 볼 때 개인적인 생각으로는 미래에는 필수적으로 가져가야한 아키텍쳐중 하나가 아닐까 생각한다.
단점
물론 장점만 있는것은 아닌데, 이렇게 선언적으로 프로그래밍을 하게 되면 무엇보다 데이터의 흐름을 직접 추적하기 어렵고, 이는 디버깅이 어려워지는 효과를 낳는다. 게다가 이 선언적 프로그래밍은 명령지향 프로그래밍보다 러닝커브가 높다. 협업이 필수인 개발자의 세계에서는 이 러닝커브가 큰 걸림돌이 될 수 있을것 같다.
마치며
사실 코드적인 부분들이 이해가 안가서 블로깅을 하려고 의도했는데.. 간단히 정리하려던 개념 부분이 생각보다 복잡하게 되었다…이것도 간략화 한거지만 ㅠㅠ
다음화부터는 본격적으로 코드를 곁들여가면서 기록을 시작해봐야겠다.
Leave a comment